OCR은 입력을 줄이지 판단을 없애지는 않습니다
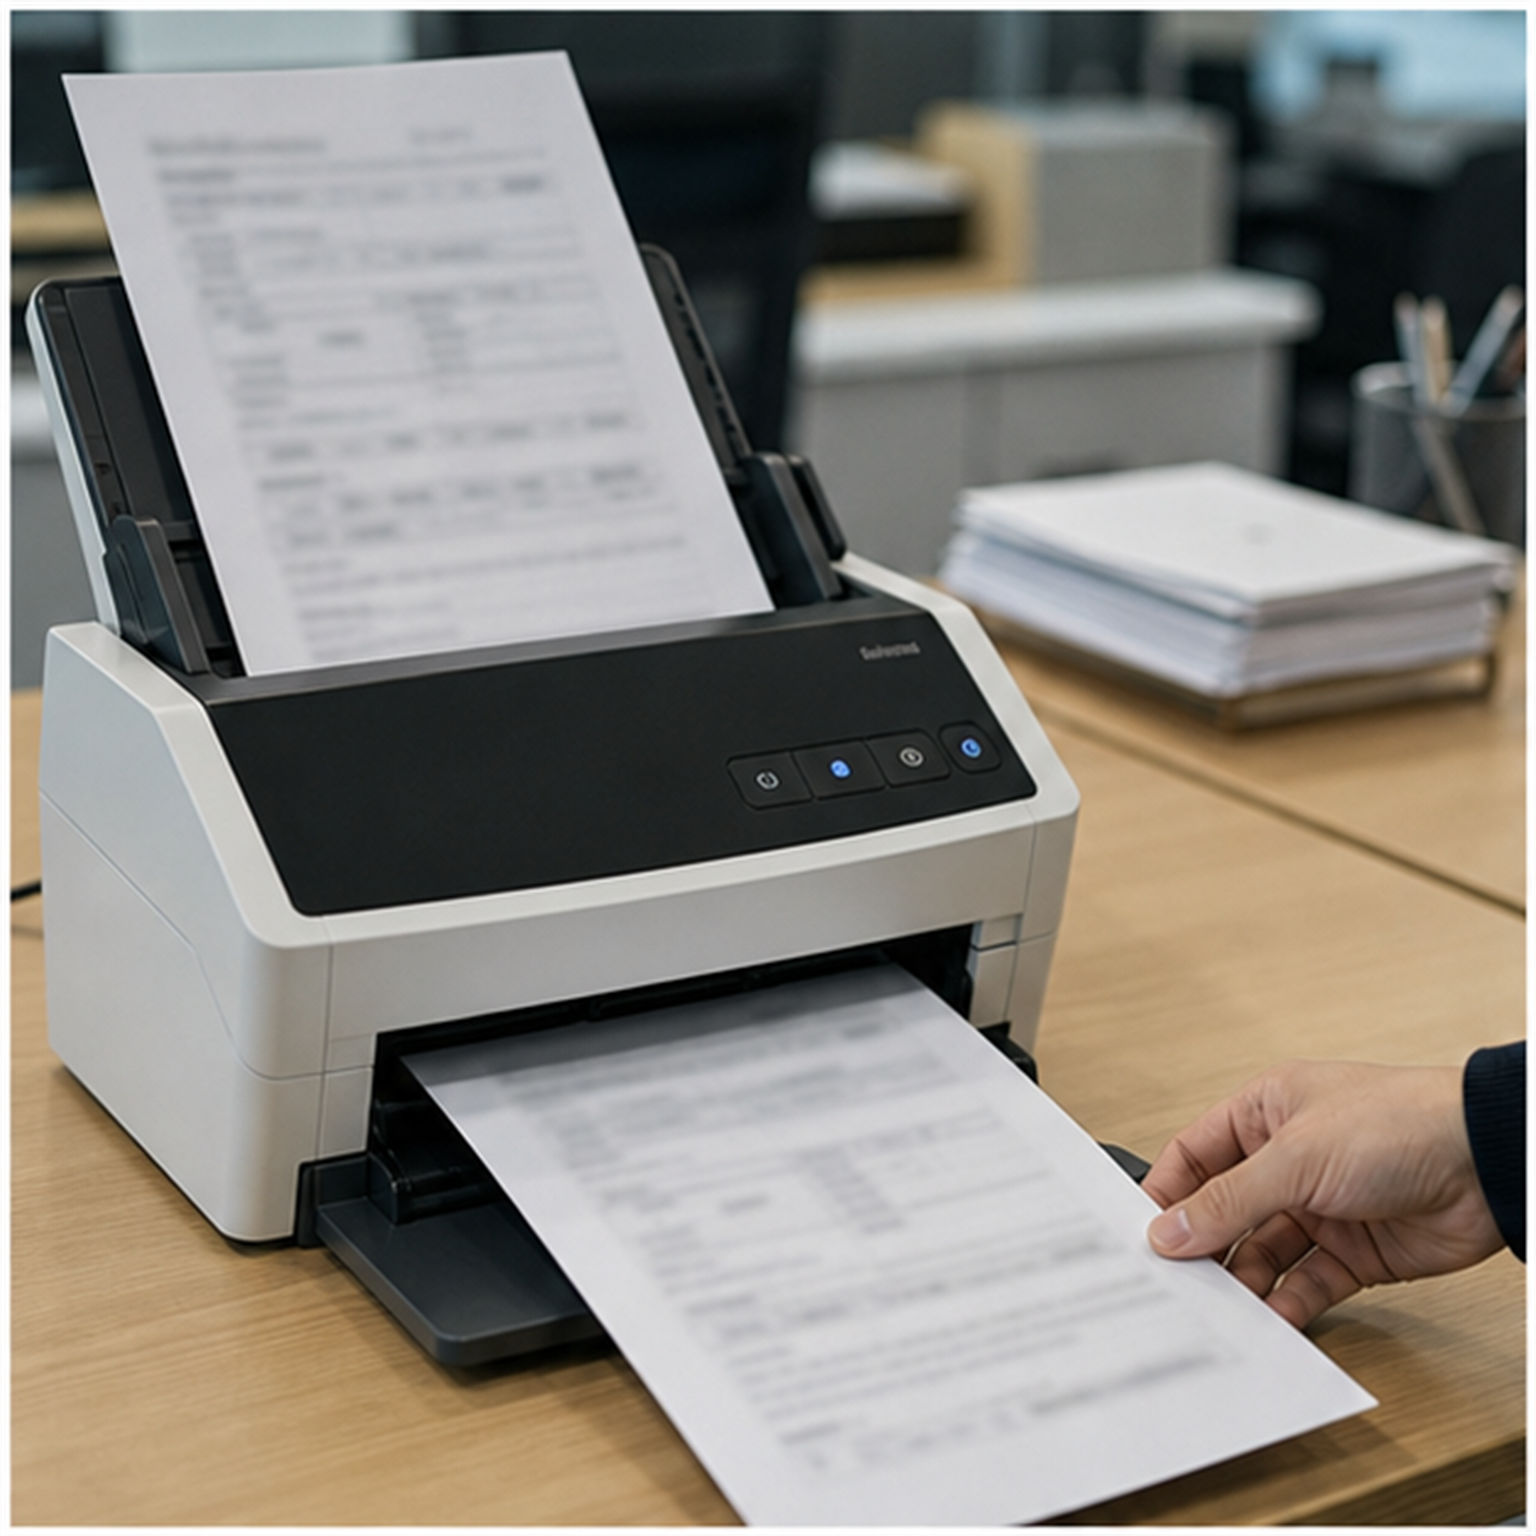
OCR은 이미지나 종이 문서의 글자를 인식해 데이터로 바꾸는 기술입니다. 견적서, 신청서, 영수증, 계약서처럼 반복 입력이 많은 업무에서는 시간을 크게 줄일 수 있습니다.
하지만 OCR이 읽었다고 해서 그 내용이 곧바로 맞다는 뜻은 아닙니다. 흐린 스캔, 접힌 종이, 작은 숫자, 비슷한 글자 때문에 오류가 생길 수 있습니다. 자동화의 핵심은 사람이 빠지는 것이 아니라 사람이 확인할 지점을 줄이는 것에 가깝습니다.
숫자와 고유명사는 항상 검수 대상입니다
문서 자동화에서 가장 위험한 부분은 금액, 날짜, 계좌, 주민등록번호처럼 틀리면 손실이 생기는 항목입니다. 한 글자 오류가 단순 오타가 아니라 잘못된 청구나 잘못된 승인으로 이어질 수 있습니다.
그래서 OCR을 업무에 붙일 때는 모든 결과를 믿기보다 신뢰도 낮은 항목을 표시하고, 중요 필드는 사람 검수 단계로 보내는 설계가 필요합니다. 자동화는 검수를 없애는 장치가 아니라 검수 우선순위를 정하는 장치가 되어야 합니다.
도입 기준은 정확도보다 예외 처리입니다
OCR 서비스의 데모 화면은 보통 깨끗한 문서에서 잘 작동합니다. 실제 현장에서는 구겨진 종이, 도장, 손글씨, 표 형식, 스캔 그림자가 섞입니다. 이때 예외를 어떻게 처리하는지가 도입 성패를 가릅니다.
문서 자동화를 검토한다면 인식률 숫자만 보지 말고, 틀렸을 때 누가 어떻게 고치는지까지 확인해야 합니다. 사람이 검수해야 할 부분을 명확히 남겨둔 OCR이 더 현실적인 업무 도구입니다.
작은 성공 사례부터 붙이는 편이 안전합니다
OCR을 도입할 때 처음부터 모든 문서를 자동 처리하려고 하면 예외가 너무 많이 생깁니다. 반복 양식이 일정하고 오류가 나도 손실이 작은 문서부터 적용해보는 편이 현실적입니다.
처음에는 자동 입력률보다 사람이 수정한 항목을 따로 모아보는 것이 좋습니다. 어떤 칸에서 자주 틀리는지 알게 되면 스캔 기준, 양식 정리, 검수 화면 설계를 더 구체적으로 바꿀 수 있습니다.
'IT•트렌드' 카테고리의 다른 글
| 네이버클라우드, 저장공간보다 먼저 볼 동기화 기준 (0) | 2026.06.04 |
|---|---|
| 원격프로그램, 편리함보다 권한 관리가 먼저인 이유 (0) | 2026.06.03 |
| VPN, 무료보다 먼저 봐야 할 보안 기준 (0) | 2026.06.03 |
| 소프트웨어 업데이트, 보안 공지보다 사용자가 먼저 볼 변화 (0) | 2026.06.02 |
| 클라우드 비용, 이전보다 먼저 따질 운영 기준 (0) | 2026.06.02 |


